AI팩토리아 · 업무 자동화
RAG란 무엇인가? 제조기업 사내 문서 검색 AI의 원리범용 인공지능의 한계부터 문서 준비·검색·답변 생성의 3단계 원리, 현장 활용 장면, 정확도와 보안을 좌우하는 요소까지
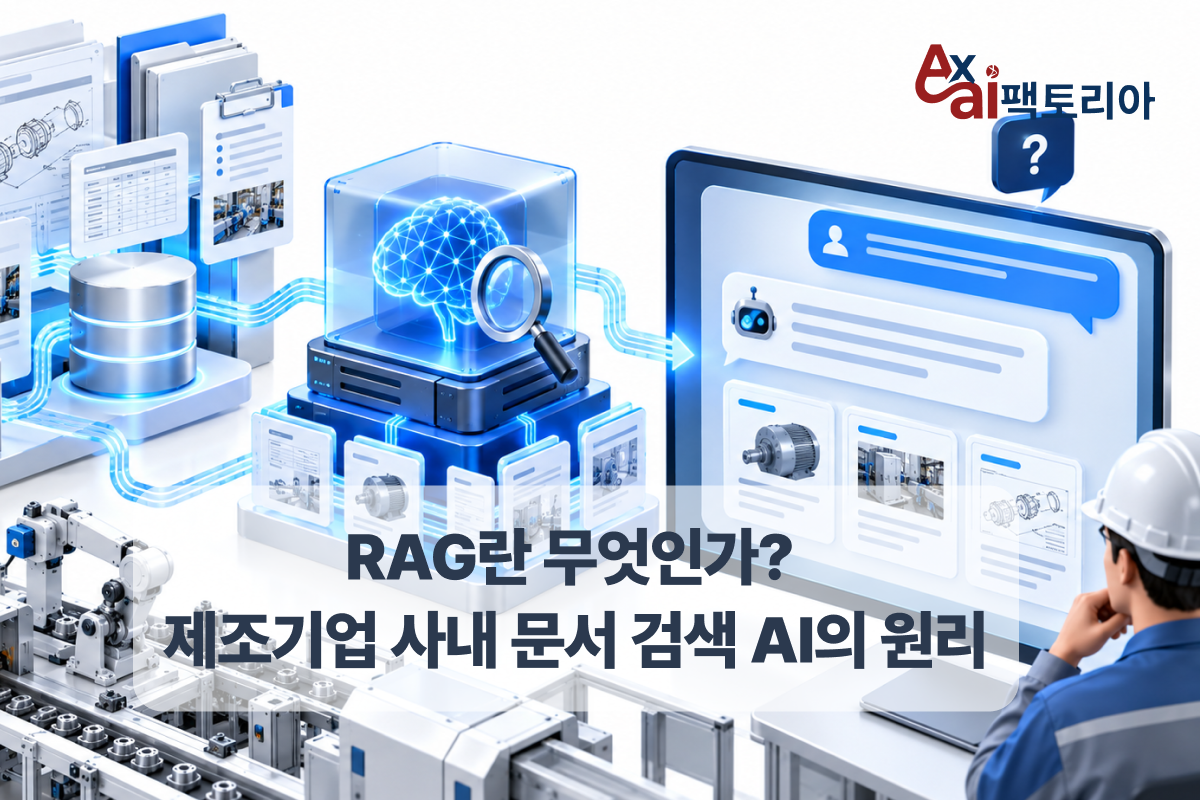
검색 증강 생성(RAG)은 인공지능이 답하기 전에 회사 문서에서 관련 내용을 먼저 찾아, 그 내용을 근거로 답을 만드는 기술이다. 작업표준서, 설비 설명서, 정비 이력처럼 이미 쌓여 있지만 찾기 어려운 사내 지식을 필요한 순간에 꺼내 쓰게 해준다. 본 글은 범용 인공지능이 사내 질문에 답하지 못하는 이유, RAG의 작동 원리, 제조 현장의 활용 장면, 도입 전에 점검해야 할 문서 품질과 보안 기준을 현장 실무자 관점에서 정리한다.
숙련자는 떠나고, 기록은 찾지 못한다
제조 현장의 고령화가 빠르게 진행되고 있다. 한국노동연구원의 「제조업 고용 고령화 국제비교」에 따르면 한국 제조업에서 60세 이상 고용 비중은 2010년 5.4%에서 2025년 17.5%로 15년 만에 약 3.2배 늘었다. 같은 기간 일본은 1.2배, 독일은 약 2.5배 증가에 그쳐, 주요 제조 강국 가운데 한국의 고령화 속도가 가장 빠르다.
정부도 대응에 나섰다. 산업통상자원부는 숙련기술인의 경험과 판단, 이른바 암묵지를 데이터로 만들어 인공지능으로 보존하는 「제조 암묵지 기반 AI 모델 연구개발 사업」에 2026년 추가경정예산 480억 원을 투입해 30개 과제를 지원한다.
숙련자의 손끝 감각을 기록하는 일은 어렵고 오래 걸린다. 그런데 많은 공장에는 이미 글로 남겨 둔 지식이 쌓여 있다. 작업표준서, 설비 설명서, 정비 이력, 불량 원인 보고서, 고객사 사양서, 안전 규정 같은 문서들이다. 문제는 이 문서들이 공유 폴더 곳곳과 개인 컴퓨터, 오래된 문서관리 체계에 흩어져 있어 필요한 순간에 찾지 못한다는 데 있다.
범용 대화형 인공지능에 “3호기 사출기에서 경보 코드 E-21이 뜨면 어떻게 조치하나?”라고 물으면 그럴듯한 답이 나오지만, 그 답은 우리 공장 설비 설명서가 아니라 인터넷에서 배운 일반론이다. 이 간극을 메우는 기술이 검색 증강 생성(RAG)이다.
출처: 중앙일보, “‘오늘은 냄새 다른데?’ 이런 명장 노하우, AI 전수 될까” (2026.05) – https://www.koreadaily.com/article/20260527080244889
“명장 노하우, AI와 접목…숙련기술 디지털화 본격 착수” (2026.07) – https://v.daum.net/v/20260726053115071
1. RAG란 무엇인가
RAG는 Retrieval-Augmented Generation의 줄임말로, 우리말로 옮기면 검색 증강 생성이다. 인공지능이 답을 만들기(생성) 전에 먼저 관련 자료를 찾아(검색) 그 내용으로 답을 보강(증강)한다는 뜻이다. 2020년 발표된 연구에서 체계화된 방식으로, 언어 모델이 학습으로 익힌 지식에만 기대지 않고 외부 문서 묶음을 함께 참조하게 해 지식 중심 질문의 정확도를 높일 수 있음을 보였다1).
쉽게 비유하면 닫힌 책 시험과 열린 책 시험의 차이다. 일반 대화형 인공지능은 외운 내용만으로 답하는 닫힌 책 시험을 치른다. RAG를 붙인 인공지능은 시험장에 회사 문서철을 들고 들어가, 질문과 관련된 쪽을 펼쳐 보고 답을 쓴다. 참고할 자료가 있으면 답이 정확해지고, 어느 쪽을 보고 썼는지도 밝힐 수 있다.
2. 범용 인공지능만으로는 사내 질문에 답하지 못하는 이유
대규모 언어 모델(LLM)은 방대한 글을 학습해 문장을 자연스럽게 이어 쓰는 능력을 갖췄다. 하지만 사내 질문 앞에서는 구조적인 한계가 있다.
| 한계 | 내용 | 현장에서 생기는 문제 |
|---|---|---|
| 사내 문서를 본 적 없음 | 작업표준서, 정비 이력은 외부에 공개되지 않아 학습 자료에 없음 | 우리 설비가 아닌 일반론으로 답함 |
| 학습 이후 변화를 모름 | 지난달 개정된 검사 기준, 새로 들어온 설비 정보가 없음 | 구버전 기준으로 답할 수 있음 |
| 모르면 지어냄 | 사실이 아닌 내용을 확신에 찬 문장으로 만들어 냄 | 틀린 설정값·조치 순서가 그럴듯하게 전달됨 |
미국 국립표준기술연구소(NIST)는 생성형 인공지능의 대표 위험으로, 흔히 ‘환각’이라 부르는 지어내기(confabulation)를 꼽는다2). 제조 현장에서 이 문제는 특히 위험하다. 틀린 조임 힘, 잘못된 경보 조치 순서, 존재하지 않는 검사 기준이 자신 있는 말투로 전달되면 품질 사고나 안전사고로 이어질 수 있다.
모델을 우리 문서로 다시 학습시키는 방법(미세 조정)도 있지만, 비용이 크고 문서가 바뀔 때마다 다시 학습해야 한다. RAG는 모델은 그대로 두고 참고할 문서만 바꿔 끼우는 방식이라 문서 개정을 빠르게 반영할 수 있다.
3. 작동 원리 ① 문서를 찾기 좋은 형태로 준비한다
RAG는 크게 준비 → 검색 → 생성의 세 단계로 움직인다. 첫 단계는 질문이 들어오기 전에 미리 해 두는 작업으로, 흩어진 문서를 인공지능이 빠르게 찾을 수 있는 형태로 바꾸는 과정이다.
| 순서 | 작업 | 내용 |
|---|---|---|
| 1. 모으기 | 문서 수집 | 공유 폴더, 문서관리 체계, 정비 기록 등에서 대상 문서를 모음 |
| 2. 글자 뽑기 | 본문 추출 | 문서 파일에서 본문을 뽑고, 스캔본은 문자 인식으로 글자로 바꿈 |
| 3. 조각내기 | 조각(청크) 분할 | 긴 문서를 문단·항목 단위의 작은 조각으로 나눔 |
| 4. 의미 수치화 | 임베딩 | 각 조각의 뜻을 수백~수천 개의 숫자 묶음으로 바꿈 |
| 5. 저장 | 벡터 저장소 | 숫자 묶음과 원문 위치를 전용 저장소에 보관 |
이 가운데 핵심은 의미 수치화(임베딩)다. 뜻이 비슷한 문장일수록 숫자 묶음도 서로 가깝게 놓인다. 예를 들어 “금형 온도가 낮아 미성형이 발생했다”와 “사출물이 덜 채워지는 원인은 금형 냉각 과다”는 쓰인 낱말이 다르지만, 뜻이 가까우므로 가까운 위치에 저장된다.
조각을 나누는 단위도 중요하다. 조각이 너무 크면 질문과 상관없는 내용까지 딸려 오고, 너무 작으면 앞뒤 맥락이 잘린다. 작업표준서라면 ‘공정 단계 하나’, 불량 보고서라면 ‘사례 하나’처럼 문서의 실제 구조에 맞춰 자르는 것이 일반적으로 좋은 결과를 낸다.
4. 작동 원리 ② 질문과 가장 가까운 조각을 찾는다
작업자가 질문을 입력하면 인공지능은 질문 문장도 같은 방식으로 숫자 묶음으로 바꾼다. 그리고 저장소에서 질문과 뜻이 가장 가까운 조각 몇 개를 골라낸다. 기존 낱말 검색과 비교하면 차이가 분명하다.
| 구분 | 낱말 검색 | 의미 검색 |
|---|---|---|
| 찾는 방식 | 질문에 쓴 낱말이 그대로 들어 있는 문서를 찾음 | 낱말이 달라도 뜻이 비슷한 조각을 찾음 |
| 강점 | 설비 번호, 부품 번호, 경보 코드처럼 정확히 일치해야 하는 값 | “왜 덜 채워지지?”처럼 일상어로 묻는 질문 |
| 약점 | 현장 별칭이나 표현이 다르면 놓침 | 비슷해 보이지만 다른 번호를 섞어 찾을 수 있음 |
제조 문서에는 두 성격이 섞여 있다. “E-21 경보”는 정확히 일치해야 하고, “소음이 커졌다”는 뜻으로 찾아야 한다. 그래서 실무에서는 두 방식을 함께 쓰는 혼합 검색을 많이 쓴다. 여기에 찾아낸 조각을 관련도 순으로 다시 정렬하는 순위 재조정 단계를 더하면 엉뚱한 조각이 답에 섞이는 일을 줄일 수 있다.
검색 단계에서는 문서의 부가 정보도 함께 쓴다. 설비 번호, 공정명, 개정일, 작성 부서 같은 정보를 조각마다 붙여 두면 “2호 라인, 최신 개정본만”처럼 범위를 좁혀 찾을 수 있다.
5. 작동 원리 ③ 찾은 근거로 답을 만든다
마지막 단계에서 인공지능은 질문 + 찾아낸 조각들 + 작성 지침을 한꺼번에 언어 모델에 넘긴다. 작성 지침에는 보통 다음 내용이 들어간다.
- 주어진 자료 안에서만 답할 것
- 자료에 없는 내용은 “문서에서 찾을 수 없다”고 밝힐 것
- 답의 근거가 된 문서명과 위치를 함께 표시할 것
그 결과 작업자는 “E-21은 금형 온도 이상 경보이며, 설비 설명서 4장 2절에 따라 온도 조절기 설정값을 먼저 확인한다”처럼 답과 출처를 함께 받는다. 출처가 붙으면 작업자가 원문을 바로 열어 확인할 수 있고, 답이 틀렸을 때 어느 문서가 문제인지도 추적할 수 있다. RAG가 지어내기를 완전히 없애지는 못하지만, 답을 검증 가능한 형태로 바꾼다는 점이 가장 큰 장점이다.
6. 제조 현장에서는 어디에 쓰이나
RAG는 ‘문서는 있는데 찾기 어려운’ 업무 어디에나 쓸 수 있다. 제조기업에서 자주 검토되는 활용 장면은 다음과 같다.
| 활용 장면 | 참조 문서 | 기대 효과 |
|---|---|---|
| 설비 고장 대응 | 설비 설명서, 정비 이력, 경보 코드표 | 야간·주말에도 조치 순서를 빠르게 확인 |
| 품질 불량 분석 | 불량 원인 보고서, 시정조치 기록 | 비슷한 과거 사례와 당시 대책을 바로 조회 |
| 작업 기준 확인 | 작업표준서, 검사 기준서 | 최신 개정본 기준으로 답변, 구버전 사용 방지 |
| 고객 요구 대응 | 고객사 사양서, 품질 협정서 | 고객별 요구 조건을 영업·품질 부서가 공유 |
| 신규 인력 교육 | 교육 자료, 안전 규정, 자주 묻는 질문 | 선배에게 묻던 질문을 스스로 해결 |
특히 설비 고장 대응과 품질 불량 분석은 숙련자의 경험이 기록으로 남아 있는 대표 영역이다. 도입부에서 본 고령화 흐름을 생각하면, 이미 기록된 지식을 꺼내 쓰게 만드는 것만으로도 기술 단절 위험을 상당 부분 줄일 수 있다.
7. 정확도를 좌우하는 것은 모델보다 문서다
RAG의 답은 찾아낸 문서를 넘어설 수 없다. 낡거나 틀린 문서가 검색되면 인공지능은 그 내용을 충실하게, 그리고 그럴듯하게 전달한다. 그래서 도입 전에 다음 항목을 점검해야 한다.
- 최신본 관리: 같은 작업표준서의 개정 전·후 판이 함께 들어 있으면 서로 다른 답이 나온다. 폐기된 문서는 저장소에서 빼고, 개정일을 부가 정보로 붙인다.
- 표와 도면: 공차표, 설정값 표, 배선도처럼 표와 그림에 핵심 정보가 담긴 문서가 많다. 글자만 뽑으면 표의 행과 열이 뒤섞이므로 표 구조를 살려 변환해야 한다.
- 스캔 문서: 손글씨 점검표나 오래된 종이 문서는 문자 인식 품질을 따로 확인한다.
- 용어 통일: 같은 설비를 ‘3호기’, ‘#3’, ‘C라인 사출기’로 부르면 검색이 갈라진다. 현장 별칭과 정식 명칭을 짝지은 용어집을 함께 넣는다.
- 평가 질문 목록: 현장에서 실제로 자주 묻는 질문 수십 개와 정답을 미리 만들어 두고, 구축 후 정답률을 측정한다. 감이 아니라 숫자로 개선할 수 있다.
8. 보안과 권한: 아무나 아무 문서나 보면 안 된다
사내 문서에는 원가, 고객사 정보, 공정 비법 같은 민감 정보가 섞여 있다. RAG를 도입할 때는 정확도만큼 보안 설계가 중요하다.
- 접근 권한 상속: 기존 문서관리 체계에서 품질팀만 볼 수 있던 문서는 인공지능을 통해서도 품질팀에게만 검색되어야 한다. 검색 단계에서 질문한 사람의 권한을 확인해, 볼 수 없는 조각은 처음부터 제외한다.
- 문서와 저장소에 대한 공격: 국제 웹 보안 단체 OWASP는 대규모 언어 모델 응용 프로그램의 10대 위험에 문서 속에 숨겨 둔 지시로 인공지능의 행동을 바꾸는 공격(프롬프트 주입)과 의미 수치화·저장소의 취약점을 포함시켰다3). 외부에서 받은 문서를 그대로 넣지 말고, 넣을 수 있는 문서의 출처와 승인 절차를 정해 둔다.
- 외부 전송 확인: 외부 인공지능 서비스를 쓰면 검색된 문서 조각이 질문과 함께 외부로 전송된다. 공정 비법이나 고객사 도면처럼 밖으로 나가면 안 되는 문서가 있다면 사내 설치형 모델을 쓰거나, 전송 자료가 학습에 쓰이지 않는지 계약 조건을 반드시 확인한다.
RAG는 이미 가진 지식을 꺼내 주는 기술이다
RAG는 새로운 지식을 만들어 내는 기술이 아니라, 회사가 이미 가진 지식을 필요한 순간에 꺼내 주는 기술이다. 그래서 성패는 화려한 모델보다 문서의 정리 상태와 권한 설계에서 갈린다.
본문의 핵심을 정리하면 다음과 같다.
- 개념: 답하기 전에 사내 문서에서 근거를 찾아, 그 근거로 답을 만든다.
- 필요성: 범용 인공지능은 사내 문서를 모르고, 모르면 지어낸다.
- 원리: 문서를 조각내 의미를 수치화해 저장하고, 질문과 가까운 조각을 찾아 답을 생성한다.
- 검색: 번호·코드는 낱말 검색, 일상어 질문은 의미 검색으로 찾는 혼합 방식이 현장에 맞다.
- 정확도: 최신본 관리, 표 구조 보존, 용어 통일, 평가 질문 목록이 모델보다 중요하다.
- 보안: 접근 권한을 이어받고, 문서 반입 절차와 외부 전송 여부를 확인한다.
제조기업은 전사 문서를 한 번에 넣기보다 한 부서의 한 가지 문서 묶음으로 시작하는 시범 운영을 권한다. 예를 들어 설비보전팀의 설비 설명서와 정비 이력만으로 작게 구축하고, 평가 질문 목록으로 정답률을 확인한 뒤 범위를 넓히는 식이다. 인공지능 전문기업은 모델 납품을 넘어 문서 정리, 권한 설계, 정확도 평가까지 함께 제공하는 역량을 경쟁력으로 삼아야 한다. 숙련자는 떠나도, 찾을 수 있게 정리된 기록은 공장에 남는다.
참고문헌
- Lewis, Patrick, et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” Advances in Neural Information Processing Systems 33. 2020. https://arxiv.org/abs/2005.11401
- National Institute of Standards and Technology. “Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1).” NIST. 2024. https://doi.org/10.6028/NIST.AI.600-1
- OWASP Foundation. “OWASP Top 10 for LLM Applications 2025.” OWASP GenAI Security Project. 2024. https://genai.owasp.org/llm-top-10/
본 게시물은 AI 어시스턴트를 활용하여 초안을 작성하고 편집자의 검수를 거쳤습니다. 타 기업명 및 영업 기밀 보호를 위해 본문 중 일부 고유명사는 익명화(A/B) 처리되었습니다.